你的 AGENTS.md 是一个神经网络
你的 AGENTS.md 是一个神经网络
原文:Your AGENTS.md is a Neural Net
以及如何用梯度下降正确地训练它
很多人觉得维护自己的 AGENTS.md / CLAUDE.md 很难。当我问别人是怎么把它保持好的,诚实的回答通常是“我写下我认为 Agent 应该知道的内容”,或者“我让我的 Agent 替我写。”
很长时间里,我也是这样。我靠的全是感觉。但我知道自己能找到更好的办法。这篇文章就是我最终找到的方法。
简而言之:手写你的用户级 AGENTS.md,让它保存你的偏好;把项目级的文件当作一个神经网络来对待。给它定一个规模预算,并用实际运行过的那些会话来训练它。
文章的其余部分会具体说明这是什么意思。
随便看一个存在超过几个月的项目记忆文件,它都处于以下四种状态之一:
- 空白。 文件之所以存在,只是因为某个工具创建了它。Agent 读不到任何有用的内容,每个会话都要重新推导同样的东西。
- 臃肿。 每当 Agent 干了件蠢事,就有人往里面粘贴一条规则。一年之后它变成了 900 行,而这每一行在往后每一次会话里都要付出代价,永远如此。更糟的是,随着文件越来越大,指令遵循的效果被稀释,真正重要的规则被不重要的规则淹没了。
- 过时。 一半的规则描述的是三月份就被换掉的构建系统。Agent 要么照做,要么学会无视这个文件——其实是一回事。
- 漂移。
AGENTS.md说的是一套,CLAUDE.md说的是另一套,你今天用哪个运行器,就会拿到不同的一套指令。
共同的根源在于,文件是以一种事务性的方式、基于零散的观察来编辑的,而且追加远比整合与修剪容易。
让人沮丧的是,能告诉你该改什么的数据其实早就存在。每一次 Agent 会话都会在磁盘上留下一份会话记录。Claude Code、Codex、pi、opencode、grok、Cursor:它们全都会写日志,记录 Agent 被要求做什么、它做了什么、遵循了哪条规则、哪条规则让它栽了跟头、用户如何纠正它,以及它不得不重新摸索出什么。只是没人去读这些日志。
你首先要知道的是,我们的 Agent 记忆文件可以写在两个层级上,而它们值得截然相反的对待。下面说说我的思路。
用户级的文件是我的,我亲手写。 我的全局 ~/.claude/CLAUDE.md or ~/AGENTS.md 承载的是我的偏好和观点:质量优先于开发成本,修 bug 之前先端到端复现它,路过不稳定的测试就把它修好——哪怕它不是你的。这些是我自己拥有的偏好,很少改变。别人不应该编辑它们,任何工具都不应该“优化”它们,Agent 尤其不行。这个文件很小,而且是刻意手写的。
项目级的文件实际上是一个神经网络。 它会被加载到在该项目上运行的 Agent 会话的系统提示里,它对 Agent 行为的引导,和一个叠加在你所用模型之上的微调 LoRA 相差无几。与其像编辑普通文件那样编辑它,不如先定下一个 token 预算,然后像训练神经网络一样正确地训练它。
如果你从未训练过神经网络,整个循环就是这样:
- 一个网络拥有一组权重:一堆决定它如何表现的数字。
- 你让一个输入经过它。这就是前向传播。权重原样使用,什么都不改变。然后你得到一些输出。
- 你把输出和期望的结果作比较。这个差距就是损失。
- 你从损失出发往回倒推,找出哪些权重应当负责,然后沿着能缩小差距的方向把它们各自轻轻推动一点。这就是反向传播,而那次推动就是一次梯度步。
- 重复下去。是许多小步,而不是一次大改写。这个步长就是学习率;太大会来回震荡,太小则永远没有进展。
有两个细节对接下来的内容至关重要。你不会只根据单个样例更新,因为单个样例是零散的,还可能充满噪声;你要按批次来。而且网络的规模是固定的——更大的网络能储存更多知识,但推理时的成本也更高。
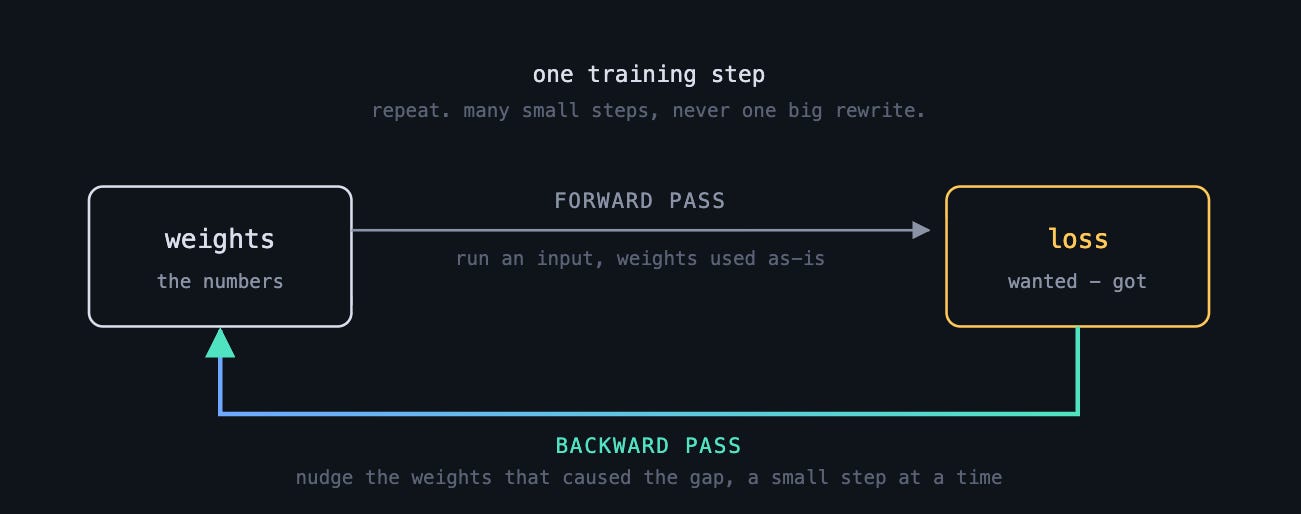
一次训练步:前向传播用权重原样跑出输出,反向传播把造成差距的权重逐次小幅推动。
现在,把这些名词换掉:
- 项目的
AGENTS.md就是权重。 在 Agent 读到任何一行代码之前,正是它决定了 Agent 在这个仓库里的行为。 - 预算就是“模型规模”。 更大的模型能容纳更多知识、产出更好的结果,但推理时的成本也更高。所以,明确预算对于把这个权衡摆到明面上很重要。
- 每一次 Agent 会话都是一次前向传播。 Agent 加载这个文件、完成工作,而文件本身不被改动。
- Agent 所做的和你所期望之间的差距,就是损失。 它重新发现了 schema。仓库明明用 pnpm,它却跑了
npm test。它违反了明摆在那里的规则。它遵循了一条结果被证明是错的规则。所有这些都记录在会话记录里。 - 阅读会话记录并更新 AGENTS.md 文件,就是反向传播。 弄清哪些指令要对损失负责、哪些物有所值,然后在预算范围内对权重做小幅更新,以降低损失。
可以看到,两者惊人地相似。这样看待 AGENTS.md 也顺应了现实——大多数人实际上并不会经常仔细阅读它的内容。在实践中,它早已是一个黑盒。
缺失的环节在于,大多数人止步于前向传播——他们在每一次 Agent 会话中使用 AGENTS.md 文件——缺少的是根据损失来精调权重的反向传播。
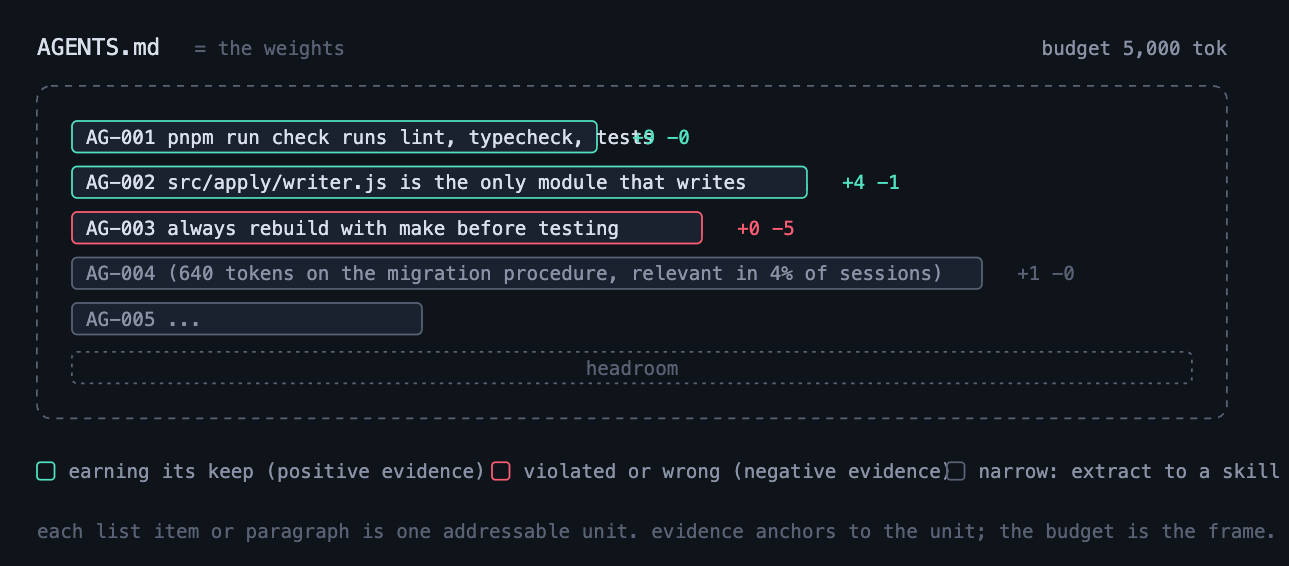
把 AGENTS.md 的每个列表项或段落当作一个可寻址单元,标注正/负证据,并在 5,000 token 预算的框架内取舍。
你可以手工完成这件事,我自己也手工做过一段时间。这套纪律分为五个部分,每一部分都对应训练循环中的某一环。
证据来自会话记录,而不是零散的印象。 损失信号应该来自 Agent 的会话日志,而不是你对上周二那次恼火经历的回忆。把 AGENTS.md 文件中的每个列表项或段落当作一个可寻址的单元,对每个单元都问一句:它在哪些会话中起了作用?被遵循了吗?被违反了吗?它本身错了吗?还要反过来问:Agent 在哪些地方出了错,却没有任何单元覆盖到?
更新之前先攒批次。 一次糟糕的会话可能只是随机原因造成的。你绝不应该仅凭它就重写权重。只有当你手头有一批数据时,才能分辨什么是真正的模式、什么只是噪声。仅这一条约束就能消除大部分臃肿,因为大多数被粘贴进来的规则,都是对某次再没发生过的事件的应激反应。
小步前进。 每一轮只做几处编辑,大约五处,每一处要么是新增、要么是删除、要么是改写、要么是抽取为技能(skill)。而不是重写整个文件。对记忆文件迈一大步,与推倒重来无异,你会丢掉所有原本行之有效的内容。
守住预算,把技能(skill)当作泄压阀。 为这个始终加载的文件定一个预算,比如 5,000 token。达到或接近预算时,更新就是零和的:每新增一条,都要指明由哪一条删除或抽取来买单。这个泄压阀就是技能(skill)。宽泛的指令(在大约 20% 或更多的会话中起作用,或者关乎安全)留在记忆文件里。有可检测触发条件的窄指令变成技能(skill)。没有可检测触发条件的窄指令则是删除候选。
严格地手工做这件事,相比基于传闻的随意编辑,确实能带来真正的改进。但这很繁琐:查找会话记录、阅读数兆字节的工具调用噪音、保持引文准确、统计 token 数。而这部分正该由工具来完成。
因此我构建了 backpass,用于以可重复的方式轻松运行这个循环。你可以在最近工作过的仓库里运行 npx -y backpass 来使用它。
它的形态只不过是上述方法变成的一条流水线。运行一次就是一步梯度步。
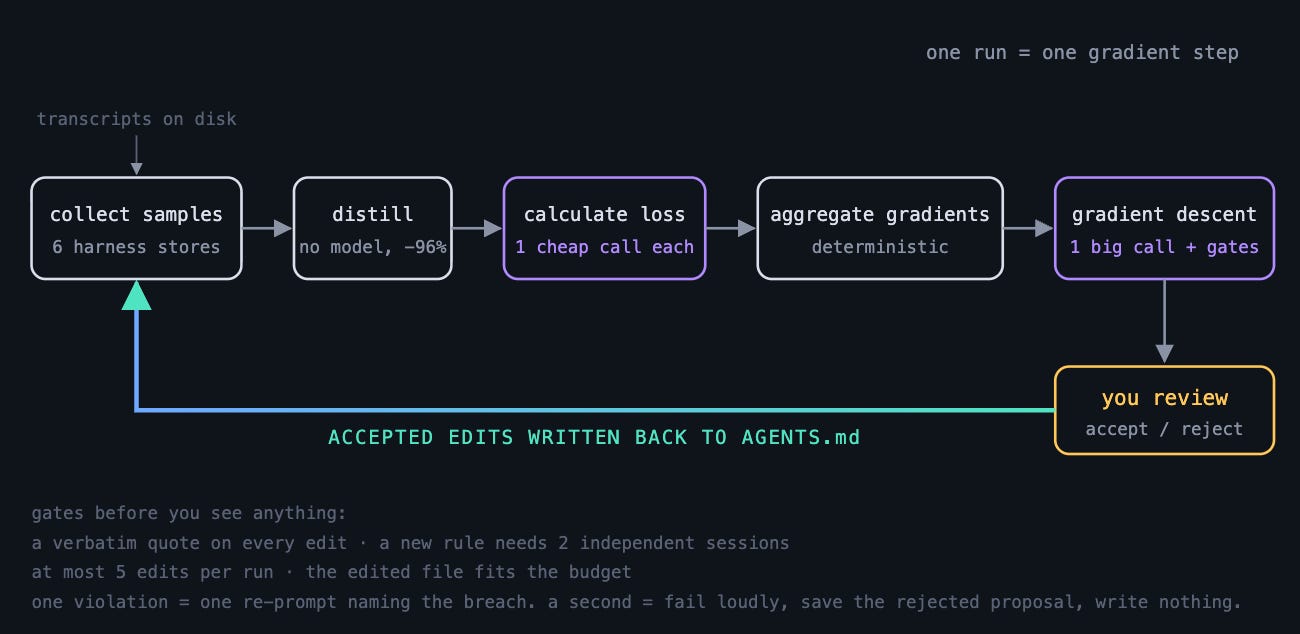
backpass 流水线:采样 → 蒸馏 → 计算损失 → 聚合梯度 → 梯度下降,最后经人工审查写回 AGENTS.md。
- 它直接从磁盘上常见 Agent 运行器的本地会话记录存储中收集样本,并通过 cwd 或 git remote 将每个会话与仓库关联起来。
- 它将每条会话记录提炼为承载损失信号的部分(问了什么、Agent 说了什么、每次工具调用的一行概要),在不涉及模型的情况下压缩了 96-99%。计算损失是对每条会话记录的一次廉价模型调用,它会为每个可寻址单元生成证据,而任何没有逐字引文的内容都会在代码中被丢弃,而不是在提示词中。
- 梯度以确定性方式聚合:每个单元的正负计数、相关性占比、跨会话聚类的近似重复缺口,以及任何在少于两个会话中出现的缺口都会被丢弃。
- 然后是梯度下降步骤,即一次高推理调用,提出编辑建议,接着由闸门机械性地把关:最多五处编辑、一条新规则需要两个会话、每处编辑都须附有引文,并且编辑后的文件要符合预算。一旦违规,只会进行一次点明违规处的重新提示;第二次则明确失败,不写入任何内容。Token 增量按实际文本计算,因为模型报告的数字永远不可信。
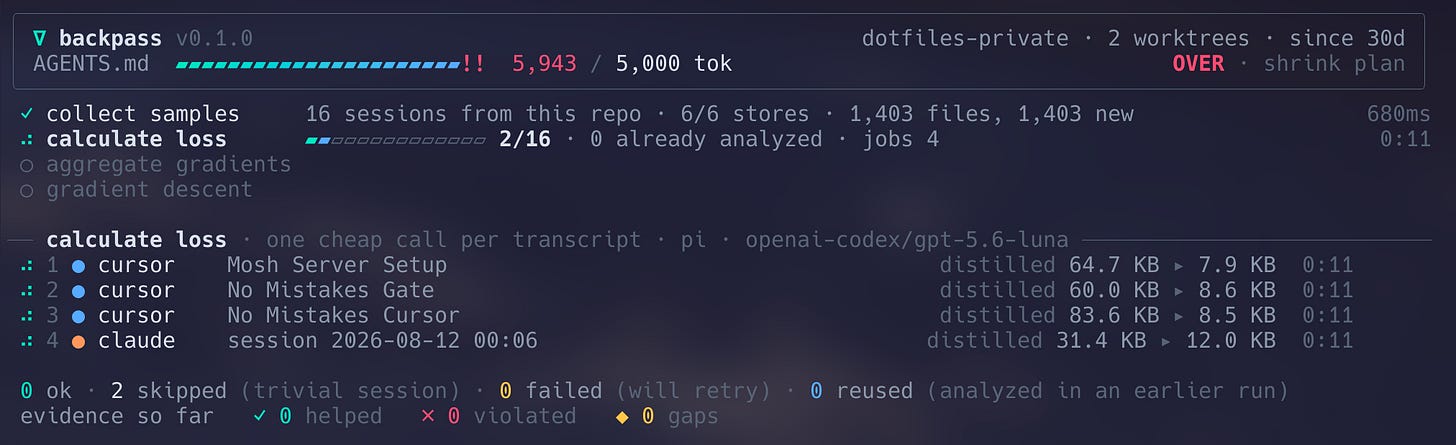
backpass CLI 运行界面:顶部显示 AGENTS.md 当前 5,943 / 5,000 token 已超预算,下方逐条展示会话蒸馏进度与证据统计。
在我审查之前不会有任何写入。backpass apply 使用 lavish-axi 展示建议编辑的列表,每项都附有 diff 和证据,我逐项接受或拒绝,被拒绝的编辑会被记住,这样同样的编辑在没有新证据时就不会再次出现。这些命令行标志就是取真实名字的训练旋钮:--budget 是模型规模,--max-edits 是学习率,--min-gap-evidence 是批次大小,--since 是训练窗口。
我养成的节奏是:每个活跃仓库每周运行一次,阅读提案,拒绝模型越界的那些,接受其余的。久而久之,AGENTS.md 就变得越来越高效、越来越有效。
一年前,任何人都可以请一个 Agent“清理一下这个文件”。这里真正重要的是科学严谨性:以真实会话记录为唯一输入,以逐字引文为唯一可采信的证据,固定预算、小步长、最小批次,以及一道负责写入的人类闸门。
如果你想试试,可以在你的仓库中运行 npx -y backpass。我也已以 MIT 许可开源了这款工具。如果你想研究它所自动化的循环,可以在 github.com/kunchenguid/backpass 找到它。