最大化 Claude Code 会话的价值
最大化 Claude Code 会话的价值
原文:Maximizing the value of your Claude Code sessions
如何组织高效的会话,让每一个 token 都物尽其用。
TL;DR
- 在任务之间运行
/clear。 这可以避免把之前无关的上下文反复发给模型,从而降低 token 消耗。 - 开工前先设好模型和努力等级(effort level)。 对话中途切换任何一个,都可能打爆你的提示词缓存(prompt caching),反而推高 token 成本。
- 用 @ 提及文件,而不是只报文件名。 文件会直接附在你的消息里,省掉一次 Read 调用——不然 Claude 还得自己搜一圈才能找到它。
- 给输出很吵的命令加上静默标志,或者丢给子代理(subagent)去跑。 命令输出会像文件一样被追加进对话,并且在会话余下的时间里一直留在那里。
- 在新会话里跑一次
/context。 它会显示当前加载了什么(CLAUDE.md、MCP 工具定义),方便你砍掉不需要的部分。 - 离开键盘前先
/compact。 提示词缓存一小时后过期,趁还在缓存里时做对话摘要要便宜得多。
价值最大化
直到不久前,你写代码用的工具还是一口价(甚至免费)。那个下午你修的是一个测试还是五十个,编辑器的价钱都一样,所以单个任务其实并没有属于自己的"价格"。
而有了 Claude Code 这类智能体化编程(agentic coding)工具,任务真的有价格了。同一件做完的活,用不同的方式去做,成本可能天差地别。
在一种会话里,Claude 读一下测试和被测文件,改完,几个回合收工。在另一种里,它先在仓库里 grep 一通,一路读上十几个文件才摸到同样的那两个——而且这些回合里的每一个,还要把从今早起就被读进对话的所有内容一起拖着走。
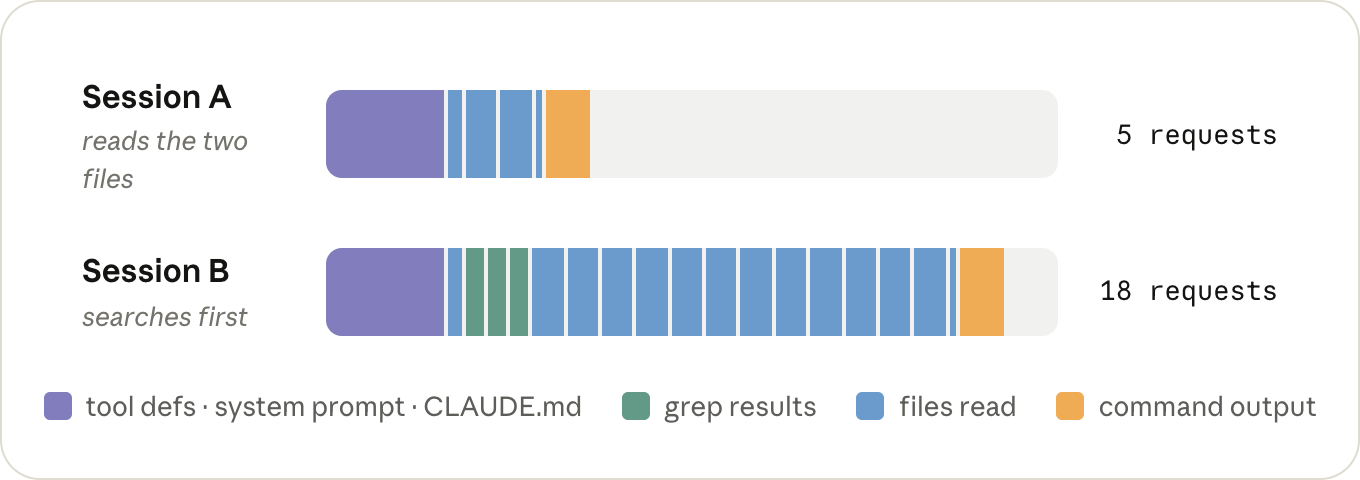 图:同一个修复任务在两种会话中的 token 消耗对比
同样一个修复,你花掉的 token 数量却不一样,而且全程模型还得围着那十个它根本用不上的文件转。
高效用 token,不是说总量越少越好,而是让你花出去的每一个 token 都花在你真正要求的事情上。
所以,我们先来看是什么决定了一个 token 的价格,再看是什么决定一个会话发送多少 token,顺便聊聊这对你怎么开会话意味着什么。
什么决定一个 token 的价格
你按 token 付费,但真正买到的其实是推理(inference):一块 GPU(或者 TPU,或者模型碰巧跑着的任何硬件)在你的 token 上跑一遍模型所花的时间。
三件事决定一个 token 占用多少这种时间:你跑的是哪个模型、它是输入 token(进去的)还是输出 token(出来的)、以及它有没有命中缓存。
模型
越大的模型,在输入和输出 token 上做的工作都越多。哪种活值得用哪个模型,这个话题本身就够单独写一篇,我们在《在 Claude Code 中选择 Claude 模型与努力等级》里专门讲过。
就本文而言,你只需要知道:我们接下来讲的一切,都要再乘上模型的价格——问题确实很难或很模糊时用大模型,日常工作用小模型。
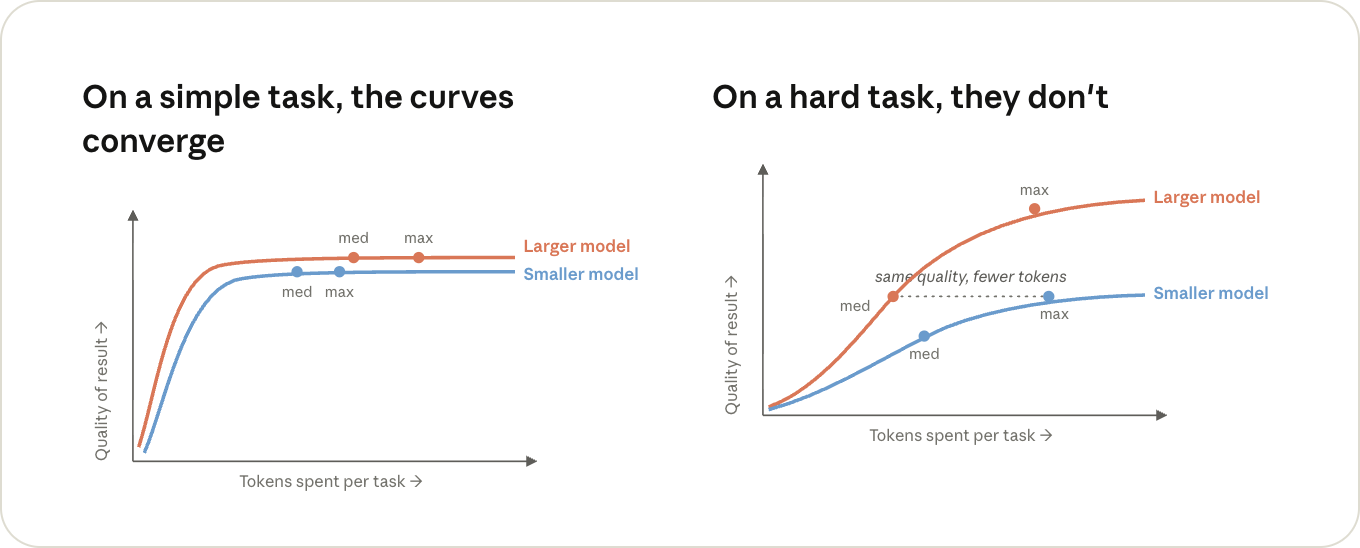 图:模型大小与价格曲线
曲线仅作示意,不代表真实基准数据。
输入与输出 token
一个请求经过 GPU 分两个阶段,两者的价钱不一样。
第一个阶段是预填充(prefill),模型读取你的请求和上下文:系统提示词、你的 CLAUDE.md、你的消息,以及此后对话里累积的一切(Claude 读过的文件、跑过的命令的输出)。这些就是你的输入 token。
然后是解码(decode)阶段,它写出输出 token:它的思考、它发起的工具调用,以及你看到的文字。这是一个 token 一个 token 来的;一个 200 token 的回复,就是模型接连跑 200 遍。单个 token 而言,decode 让 GPU 忙的时间长得多,所以输出定价大约是输入的 5 倍。
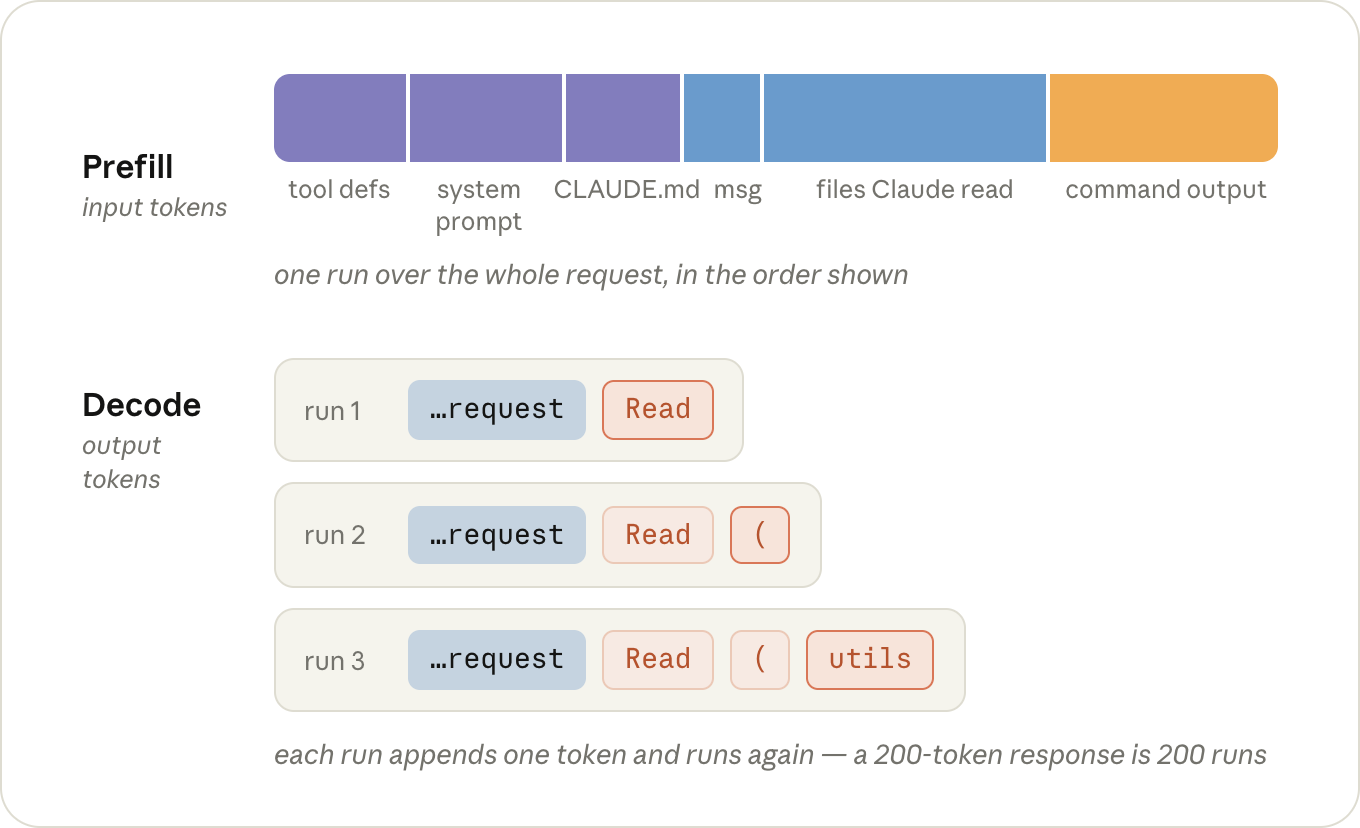 图:请求经过 GPU 的两个阶段——prefill(读入)与 decode(写出)
一个会话里的输出 token,有很多是思考 token(thinking tokens),而模型每轮思考多少,正是努力等级(effort level)控制的。和模型一样,你用 /effort 选的等级也会留到下一个会话当默认值。
提示: 在新会话里跑一次/model和/effort,看看自己现在到底在用什么。两个都会记住你上次的选择,而这个决定应该是有意识做出的。
提示: 如果你已经知道某个会话就是纯苦力活,MAX_THINKING_TOKENS=0claude 可以在这一次会话里把思考整个关掉(Fable 5 除外)——这是比/effortlow 再低一档。
提示词缓存(prompt caching)
如果一个请求的开头 token 和服务器刚见过的某个请求一模一样,那这段共同开头算出来的状态(state)也一样,于是服务器可以把上次的留着,只预填充后面新增的部分。这就叫提示词缓存(prompt caching)。
从缓存读取的价格是输入价的 0.1 倍,因为服务器是直接加载状态,而不是重新算一遍。把 token 写进缓存则比正常输入贵一点,最高 2 倍,因为服务器之后还得把这个状态留着。但写每个 token 只发生一次,而 0.1 倍的读取,在其后的每一轮都会发生。
Claude Code 在每次请求上都会自动管理提示词缓存,不需要你开启什么。但你可以把它弄坏,所以知道怎么避开这些成本尖峰很重要。
假设我们输入 "fix the failing test in utils.test.ts"(修复 utils.test.ts 里挂掉的测试)。Claude Code 会这样发请求:
- Claude Code 用系统提示词(含工具定义)、你的
CLAUDE.md和你的消息组装出第一个请求,发出去(输入 token)。这时缓存里什么都没有,所以全部内容都要预填充并写进缓存。 - 模型没见过测试就没法修,于是它想了一下,回了一个对
utils.test.ts的 Read 调用(输出 token)。Claude Code 读文件,把它追加进对话,然后整个再发一遍(输入 token)。这一次,请求 1 的全部内容都以十分之一的价格从缓存读回,唯一按全价预填充的是新增部分:那个 Read 调用和文件本身。 - 接着模型想要被测的那个文件(输出)。再一次 Read、再一次追加,然后又全部发出去:请求 1 和 2 走缓存,第二个文件按全价(输入)。
- 模型回了一个 Edit(输出)。Claude Code 应用修改、追加结果,然后又把所有东西发一遍。老规矩:Edit 和它的结果是新的,它们前面的所有内容都是缓存读取(输入)。
- 模型跑
npm test(输出)。Claude Code 追加测试输出,再发一次全部内容,测试输出是唯一的新增部分(输入)。 - 测试通过,模型回了一段简短总结(输出)。没有工具调用就意味着没有新内容要追加,也就没有第 6 个请求,收工。
一个小修复就是五个请求,而且每个请求里都装着到那时为止的完整对话。一轮典型的交互是严重"头重脚轻"的:几万 token 进去,几百 token 出来。但只有那一轮新增的部分,才按全价预填充。
每一轮的账单就是这些:历史部分走缓存读取,新增部分按全价输入,回复部分按输出价。
订阅用户也一样。你看不到这些价格,但消耗你额度的,正是这些同样的请求。
缓存必须从请求的最开头一路匹配下去,而且请求总是按同样的顺序发出:先是工具定义,然后是系统提示词,最后是对话(CLAUDE.md 排在对话最前面)。
这个前缀里任何东西一变,它后面的所有内容都得重新预填充。往对话末尾追加一个工具结果是理想情况,因为后面没有别的东西了。真正把缓存扔掉的,是那些改动请求更靠前位置、或者改变缓存键(cache key)的操作:
/model:每个模型都有自己的缓存,所以下一轮整个对话都要按全价重新预填充。(opusplan 也一样——你每次进出 plan 模式,它都会切换模型。)/effort:努力等级也是缓存键的一部分,所以同样的事会发生。这也是为什么在对话中途切换时,/model和/effort都要弹出来让你确认。- Fast mode(快速模式):同样是缓存键的一部分,而且重新预填充是按 fast mode 的价格算的,所以要用就一开始就用。(再关掉倒是免费的,缓存上不亏。)
/compact:对话会被替换成一个更短的版本,原有内容就全都匹配不上了(对话前面的系统提示词倒是保得住)。只要旧对话还在缓存里,写摘要本身就很便宜,所以长时间休息前 compact,比休息后便宜得多。- 时间:每一轮都会重置计时器,但缓存在订阅用户那里一小时后过期,API key 用户则只有五分钟(设
ENABLE_PROMPT_CACHING_1H=1可以延长到一小时)。超过这个时间再回来,下一轮就得把整个对话重新预填充。恢复旧会话几乎总是这样:那时缓存通常早就没了,而且系统提示词本来也会在启动时重建。
这一切不是说你就永远不能换模型或换等级,而是说做这件事有便宜的时刻——会话开头、或刚 /clear 完——也有昂贵的时刻:一场长对话的中途。
提示: 如果最后几轮跑偏了、你不想要了,用/rewind回退到它们之前,而不是跑/compact。回退只是从末尾砍掉那几轮,前面的内容还在缓存里,一分钱不花。Compact 要重写整个对话,所以多少总要花点钱。
什么决定一个会话发送多少 token
这里最需要记住的一点是:没有任何东西只被发送一次。凡是进入对话的东西——Claude 读过的文件、跑过的命令的输出——在其后的每一轮都会被再发一遍,一直持续到会话结束。
它们在缓存里,所以每次重发都便宜——但便宜不等于不要钱,而且它们还占着上下文的空间,模型每一轮都得绕着这些东西想。
这就是一个会话完整的成本模型:有多少 token 进入上下文、它们停留多少轮、以及你同时跑着几个上下文。
上下文里都进了什么
有一部分内容,在你敲下任何字之前就已经在上下文里了:工具定义、系统提示词、CLAUDE.md,以及其他启动时加载的东西。
提示: 在新会话里跑/context,看看你还没打字时里面都装了什么。CLAUDE.md只留具体指令,把特定流程的东西挪进 skills——它们只在使用时才加载。如果这个会话用不上某个 MCP 服务器,用/mcp把它关掉。
会话期间新增的其他内容,几乎全是工具结果:Claude 读的文件、它跑的命令的输出。
Claude 读多少,基本上取决于它得自己摸清多少。你说"测试挂了",它得先搞清楚是哪些测试:一两次 grep、打开几个文件看哪个相关——而这些结果早在失去用处之后,还会长期留在上下文里。
"Fix the failing test in utils.test.ts"(修复 utils.test.ts 里挂掉的测试)跳过了搜索,只花一次读文件的 Read 调用;而 "Fix the failing test in @utils.test.ts" 连那次 Read 调用都省了。
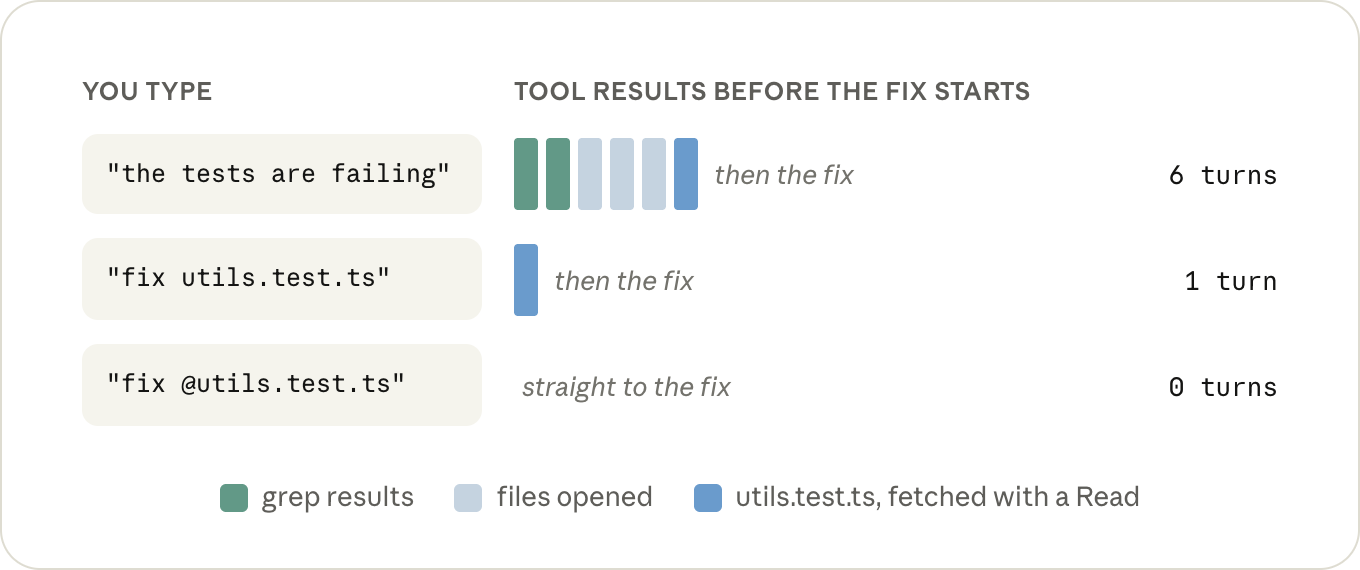 图:用 @-mention 直接附带文件,省去一次 Read 调用
提示: 提到某个文件时,用 @ 提及它,别手打路径。Claude Code 会在任何内容发出之前,把文件附到你的消息上,所以第一个请求里就有它,也就不需要 Read 调用。无论哪种方式,文件本身在上下文里占的空间都一样,所以每个对话里提一次就够了:它会一直留在那儿,后面再 @ 一次,通常只会多附一份副本。
另一个填满上下文的,是 Claude 跑命令的输出。每次它跑测试、构建或 git log,打印出来的东西都会像读过的文件一样被追加进对话,并停留同样多的轮数。
特别大的输出反而没事:超过 30,000 字符后,Claude Code 会把输出写进文件,只在对话里留一小段预览和文件路径(想改这个值可以用 BASH_MAX_OUTPUT_LENGTH)。
问题出在低于这个门槛的所有输出。一个测试运行器一行一条地打印 400 个通过的测试,这并没超限,而这 400 行从此就成了之后每一轮的一部分。
Claude 通常会用各种标志和 tail 替你搞定这事;如果你不想全指望它,官方文档里有个小 hook,能在命令跑之前改写这些吵闹的命令,只把要紧的行带回来。
提示: 把你整天都在跑的那两三条命令写进CLAUDE.md,连同静默标志一起,就按你自己会敲的样子写(比如"用npx vitest run <file> --reporter=dot跑单个测试文件")。改动虽小,但之后的每个会话都能省下一整轮交互和几百行输出。
它们在里面停留多少轮
一个长会话,比把同样的活拆成几个短会话更贵,而且贵得超出你的想象——因为第 40 轮还要把前面 39 轮重读一遍。你要的是会话里的上下文又短又相关,所以别把一个任务的上下文带进下一个:开新事情就 /clear,同一任务的早段做完了就 /compact。
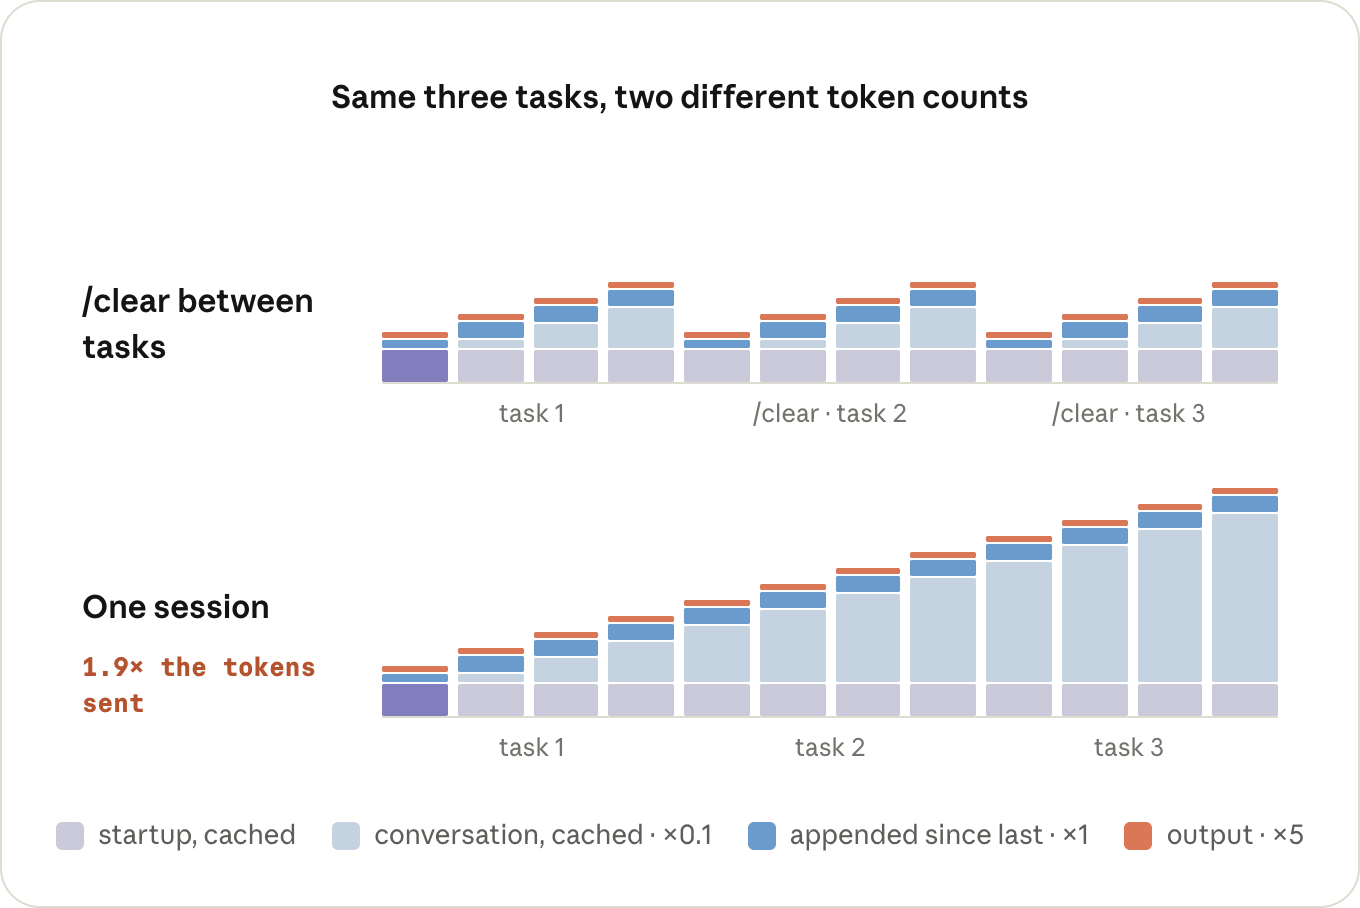 图:一个长会话 vs 多个短会话的 token 消耗
提示: 如果以后还想找回这个会话,/clear之前先/rename。跑/compact时告诉它要保留什么;如果每次要保留的东西都一样,就在CLAUDE.md里写一节 "Compact instructions"。另外,如果你在用 1M 上下文的模型、想让 auto-compact 安全网回到老位置,/autocompact 200k可以把它调回来(需要 Claude Code v2.1.221+)。
你没在敲键盘时发生的那些轮次,也要留意。/loop 会在你设置它的那个会话里作为完整的一轮触发,每次都拖着整个对话一起走;而且如果距上一轮已超过一小时,还要再叠加一次缓存未命中。开个新终端、起新会话,让 loop 从那里跑。
子代理(subagent)
把东西挡在你上下文之外的另一个办法,是让它在别的上下文里发生——这正是 subagent 的用途。一个 subagent 有自己的上下文窗口,有自己的系统提示词、工具和你的 CLAUDE.md,但没有你的对话。它自己跑自己的轮次,最后回到主会话的只有它的答案,其他一切在它干完时就被扔掉了。
拿不到你的对话的坏处是:subagent 有时得重读主会话早就读过的东西,而且重读时它还得为自己那些轮次付费。小活儿交给它,就纯属开销。
但当一个活儿会产生大量你不需要保留的输出时——比如翻一份日志——它就值了。这种事 Claude 常会自己起一个 subagent;它没起的时候,你也可以直接要("用 subagent 翻一下这份日志")。只是记住:主会话拿回来的,只有 subagent 选择汇报的那部分。
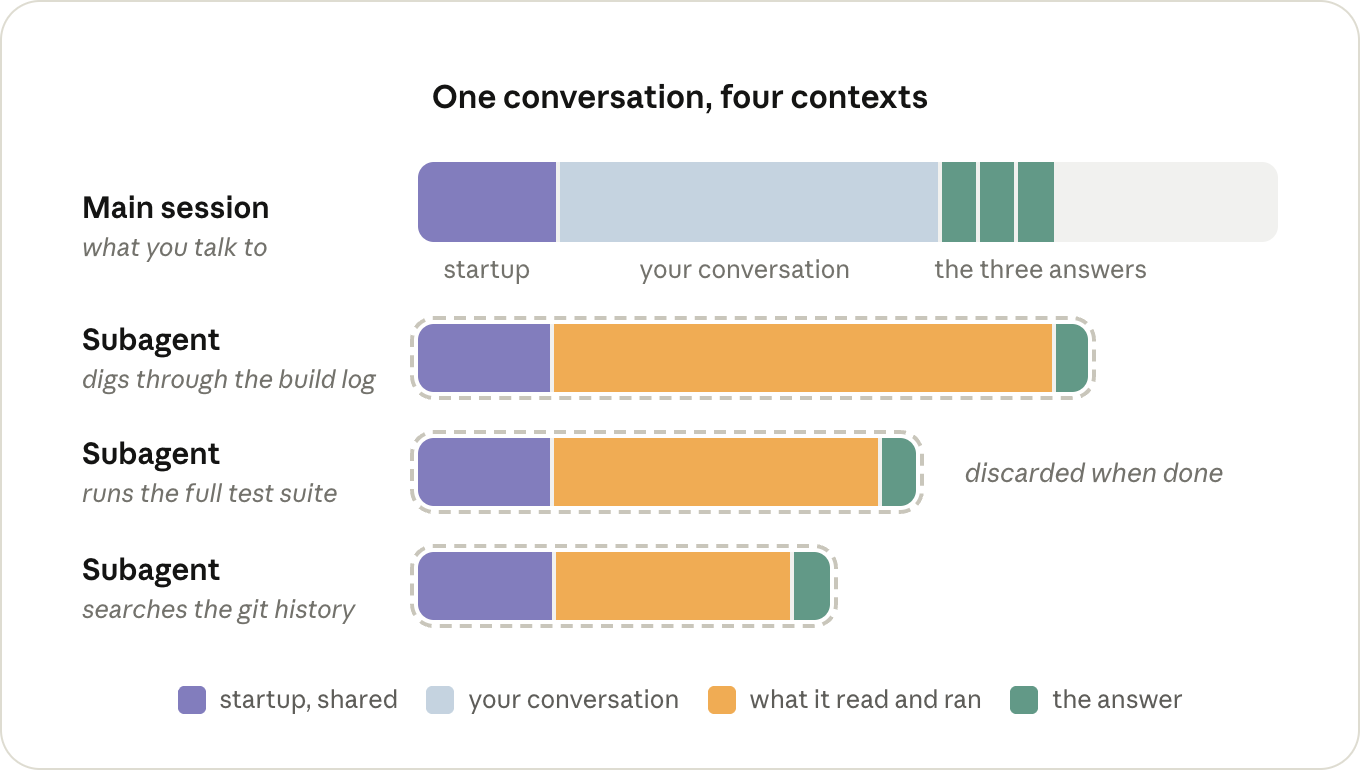 图:subagent 拥有自己的上下文窗口,只把答案带回主会话
提示: 如果有个吵闹的活儿你反反复复往外派,就给它单写一个 subagent 定义,指定 model: haiku(或 sonnet)。不指定的话,它就跟着你主会话当前用的模型跑。
先从哪里看起
在以上所有内容里,有四件事值得盯着,大致按成本高低排序:
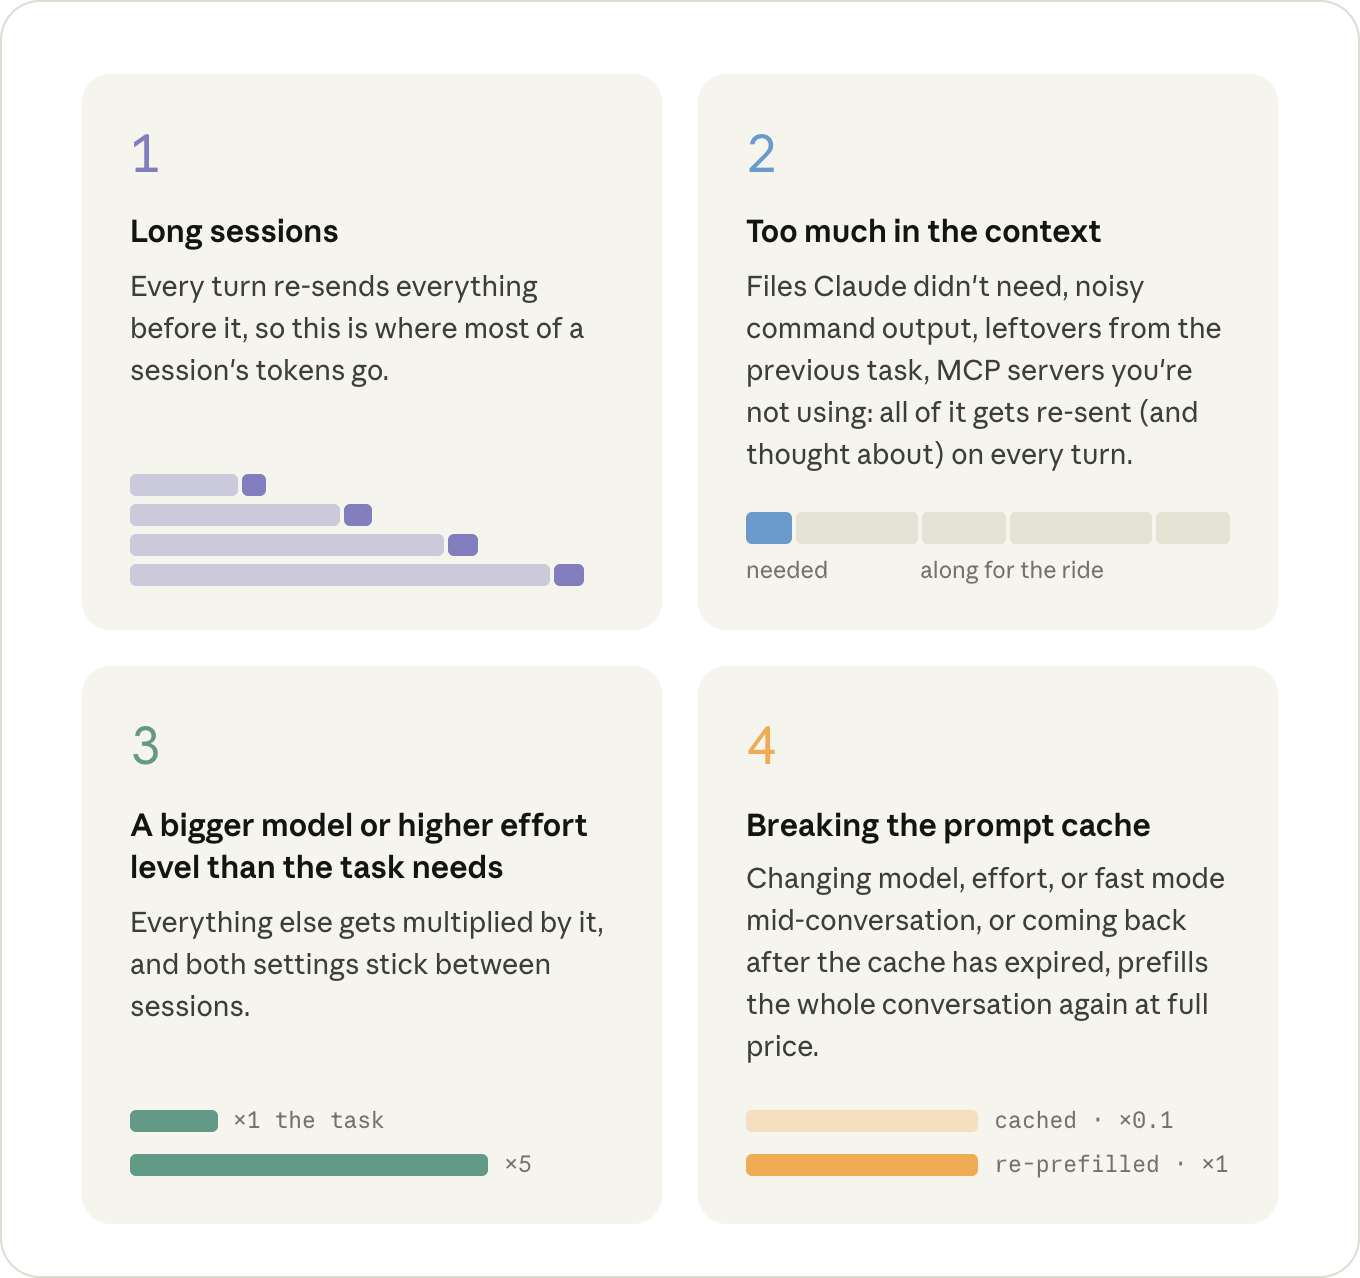 图:最值得优先关注的四件事(按成本排序)